
如何决定开哪些店、关哪些店?
一家店自己的数字,说明的是它的经营情况,而不是没有它网络会失去什么。把门店放在一起衡量,才能回答真正重要的问题。
门店网络规划是把一家连锁企业的门店放在一起衡量,而不是逐家孤立地看,据此决定在哪里开店、保留或关店。围绕每家门店画出同样的车程商圈,统计各自独自覆盖的居民,再按关店后留下的未覆盖居民数给关店排序,按新增居民数给开店排序。
为什么很难单看网络中的某一家店来判断?
一家数字平平的店,可能服务着您的其他门店都够不到的居民;一家看起来很忙的店,也可能正好落在另外两家店的商圈之内。它自己的报表分不清这两种情况。
答案还会随着您的行动而改变。关掉一家店,它共享的顾客会转到邻近的门店,那家店就更难关了。开一家店,旁边的门店会失去一部分覆盖范围。
所以有用的结果不是每家店一个分数,而是一个顺序:哪次关店损失最小,哪次开店增加最多,并且每一步之后都要重新测量。
在布里斯班的例子里,两家计划新店会吸引的居民消费中,有这个比例来自连锁企业自己的门店,而不是来自市场的其他部分。
K-Stra Coverage,2026 年 11 月 1 日,针对 10 家门店的示例网络:每年 A$ 3,884万的商圈居民模型消费中,A$ 840万来自自有门店;ABS 人口 2025。
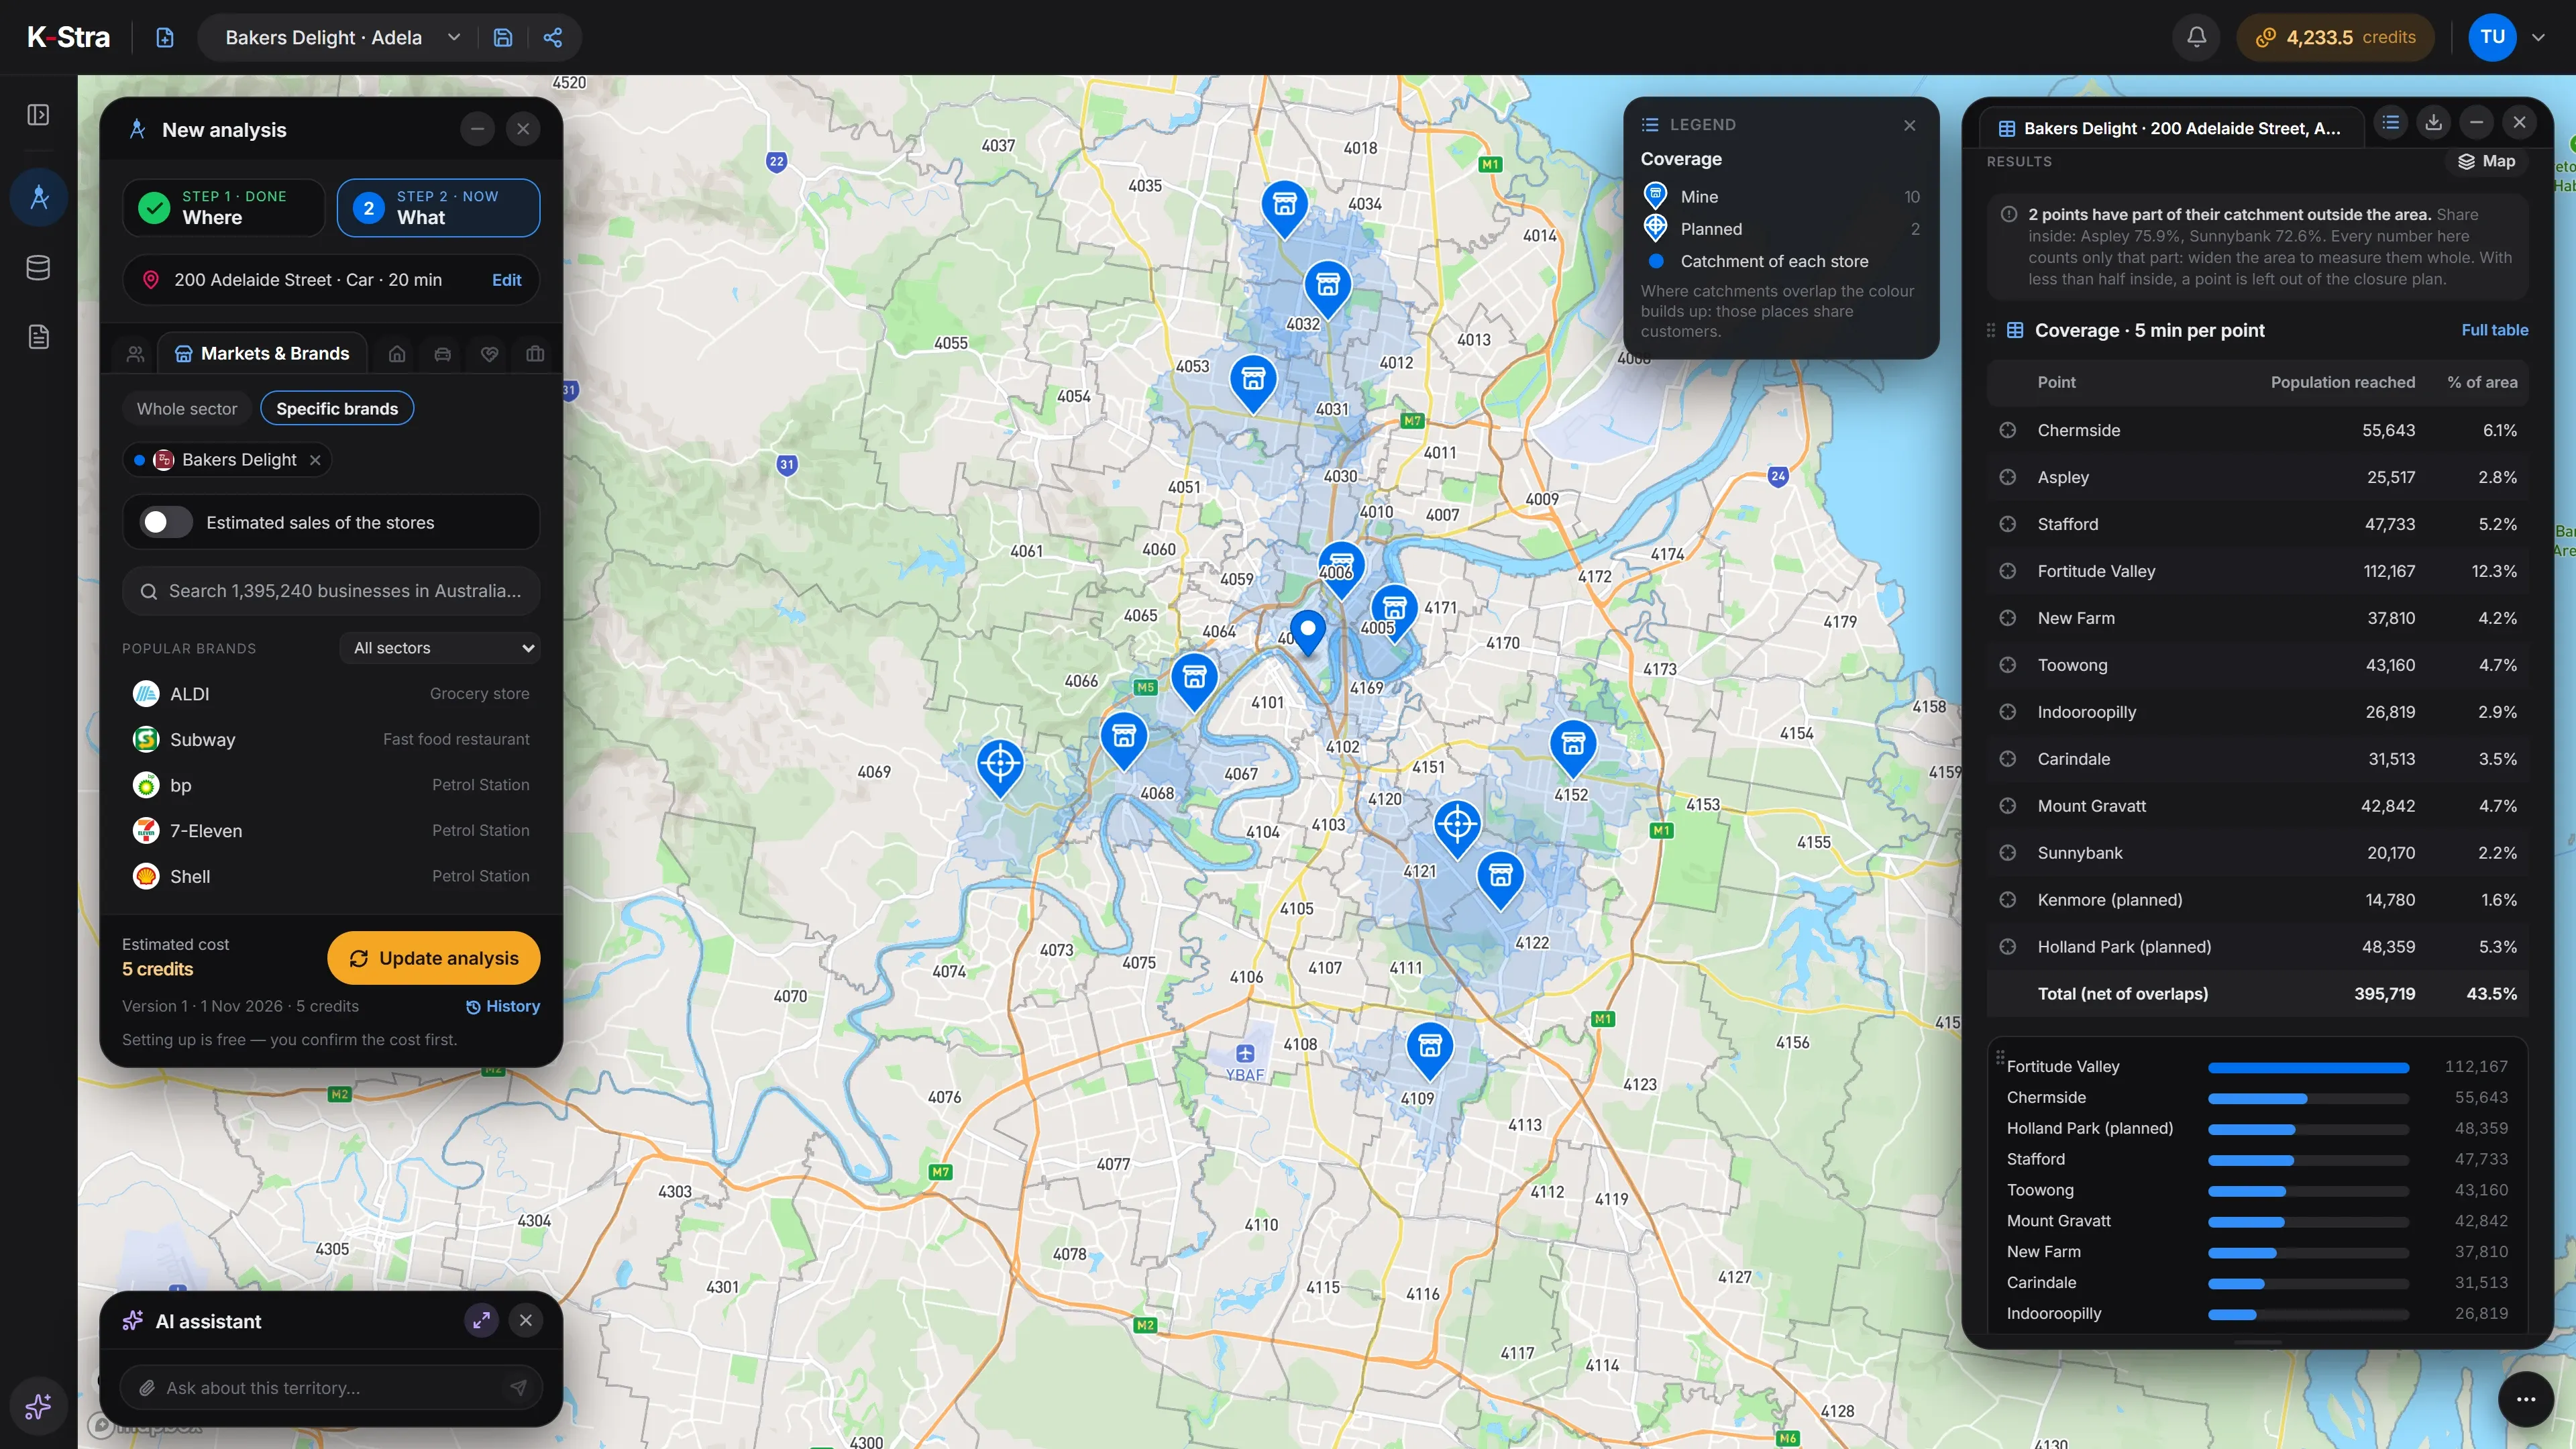 示例数据 · 布里斯班
如何一步步规划门店网络?
列出每家门店
现有门店和候选地点,每一个都带坐标或所在地的地址。
全部使用同一个商圈
每家店周围都用同样的车程时间,这样位于高速公路旁的店和位于繁华商业街的店,用同一把尺子衡量。
统计每家店独自拥有的居民
对每家店,统计您的其他门店都够不到的居民。这就是关掉它会失去的。
给关店排序
先在纸面上关掉让未覆盖居民最少的那家;对剩下的门店重新测量;如此反复。
给开店排序
先在纸面上开出新增居民最多的候选地点,也就是您的任何门店都够不到的居民;重新测量;如此反复。
检查每个新店会从您手里分走什么
一个能增加大量居民的候选地点,仍然可能大量分走您附近已有门店的顾客。
做决定,然后再测量
把方案当作一个序列,而不是一份清单:每一次变动,都会改变周围门店的数字。
做门店网络规划需要哪些数据?
您的门店清单,以及您正在考虑的地点。人口、消费和道路网络随分析一起提供。
您的门店
一份 CSV 或 Excel 文件,每家门店有编码、名称,以及坐标或地址。
文件格式与限制(英文)候选地点
在地图上放置的点,或同一份文件中的行,标记为计划中,而不是现有门店。
零售选址道路网络上的居民
ABS 截至 2025 年 6 月 30 日的人口估计;即使被多个商圈同时覆盖,也只统计一次。
人口数据(英文)按行业划分的居民消费
居民的家庭消费,用来看一家新店会与周围的门店如何分享这笔消费。
收入与消费数据(英文)
K-Stra 运行在悉尼的一台专用服务器上:您的数据集、分析和结果都留在澳大利亚。地图底图、付款和登录服务都接触不到您的文件。只有三个环节可能接触:地理编码只发送地址文字,而且要在您确认之后;当您就某个数据集提问时,AI 助手会读取列名和数值;邮件通知会带有您分析中的数字。您的数据存放在哪里。把数据集标记为“session only”(仅限本次会话),它会在上传 24 小时后删除。
如何在 K-Stra 里规划门店网络?
Coverage(网络覆盖)一次读取整个网络。每个点要么是您的,要么是竞争对手的,要么已经存在,要么还在计划中;结果以四张表呈现。
- 添加网络在 Markets & Brands(市场与品牌)分析中打开 Coverage,从 “My Data”(我的数据)添加您的门店,或者直接在地图上点击。每家门店或候选地点 5 积分。
- 标记每个点现有还是计划中,是您的还是竞争对手的。选择商圈的分钟数,最多 30 分钟。
- 关店方案按损失居民最少的顺序排列您的门店,并显示每一步之后剩下的覆盖。
- 开店方案按新增居民最多的顺序排列您的计划地点,并显示每个地点会从您现有的门店分走什么。
Coverage 还会建模每个点能吸引商圈居民多少消费,以及从谁那里吸引。这是只针对居民的模型,用来在同一区域内比较同一行业的地点:请把数值读作一个数量级。
关店方案用数字看是什么样的?
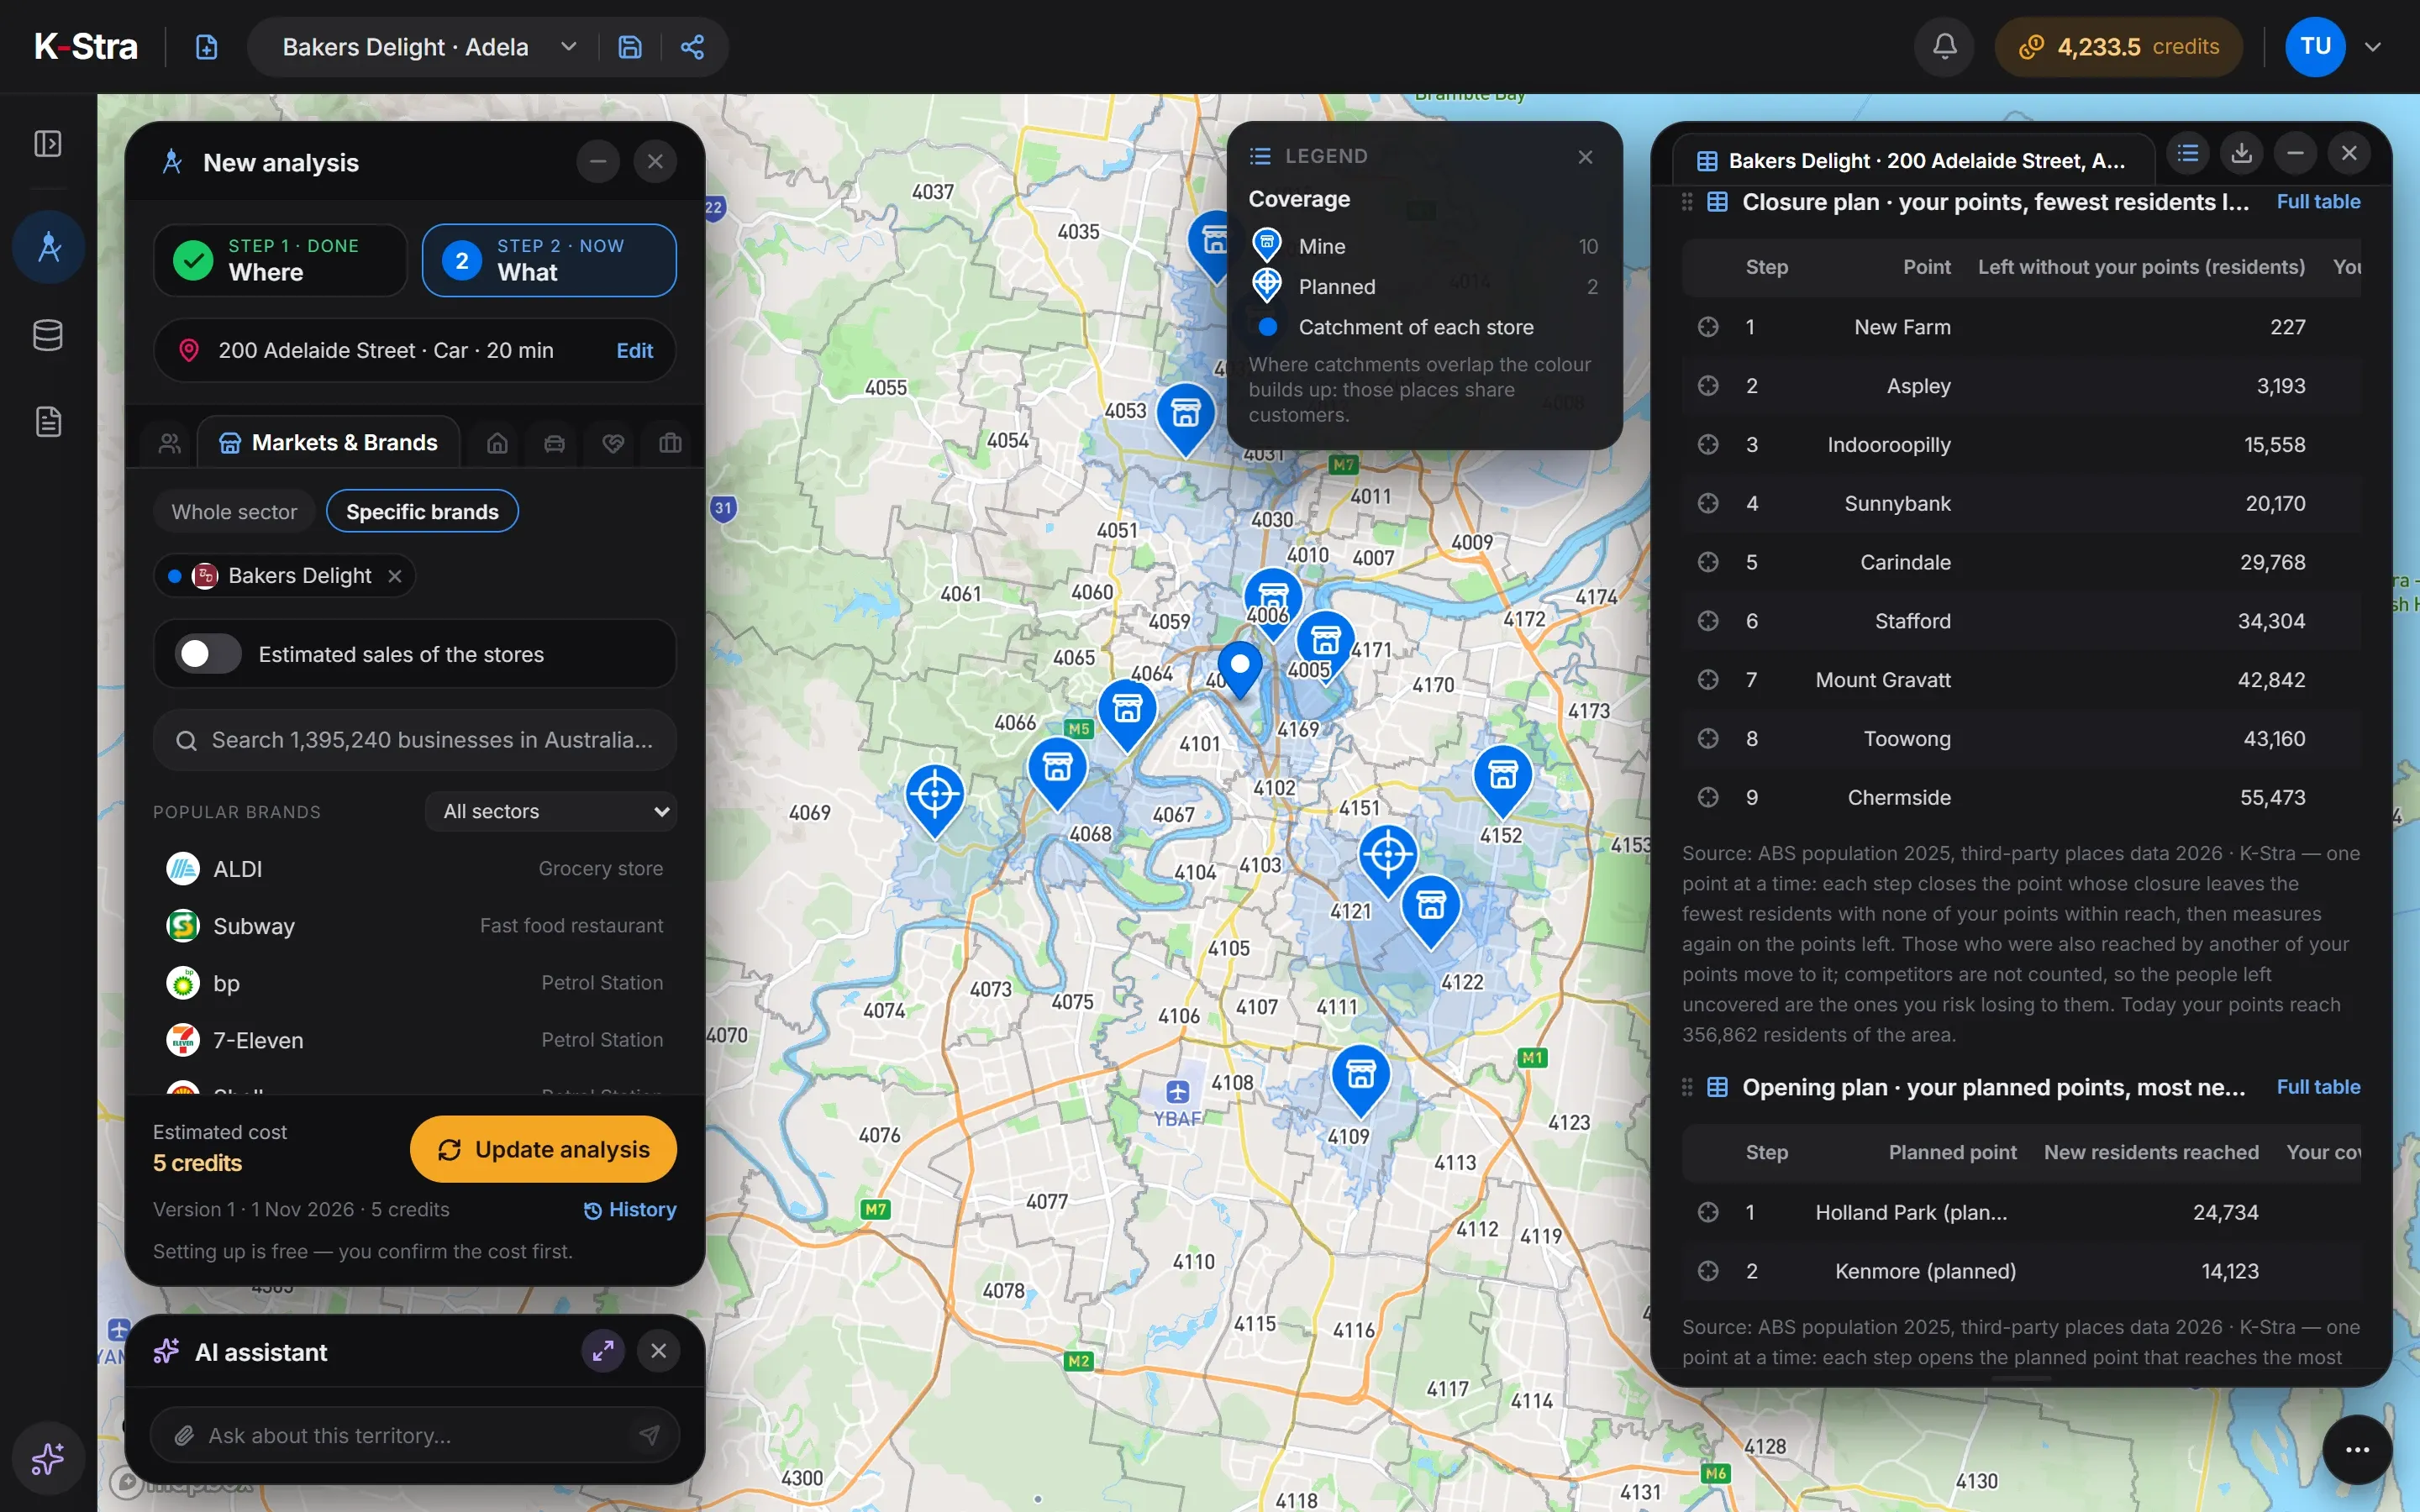
布里斯班一个示例连锁的 10 家烘焙咖啡店,每家店有 5 分钟车程商圈,所在区域共有 909,837 名居民。目前这个网络覆盖其中的 356,862 人,占 39.2%。关店方案一次去掉一家店,每次去掉的都是关闭后让连锁企业的所有门店都够不到的居民最少的那一家。
| 门店 | 覆盖的居民 | 与自有门店共有 | 关店步骤 | 该步骤后未覆盖 |
|---|---|---|---|---|
| New Farm | 37,810 | 99.4% | 1 | 227 |
| Aspley | 25,517 | 87.5% | 2 | 3,193 |
| Indooroopilly | 26,819 | 44.4% | 3 | 15,558 |
| Sunnybank | 20,170 | 0% | 4 | 20,170 |
| Carindale | 31,513 | 5.8% | 5 | 29,768 |
| Stafford | 47,733 | 28.1% | 6 | 34,304 |
| Mount Gravatt | 42,842 | 59% | 7 | 42,842 |
| Toowong | 43,160 | 26.1% | 8 | 43,160 |
| Chermside | 55,643 | 59.3% | 9 | 55,473 |
| Fortitude Valley | 112,167 | 35.4% | 最后 | — |
来源:K-Stra 示例账户中一家虚构连锁的示例门店网络;ABS 2025 年 6 月 30 日人口;K-Stra Coverage,2026 年 11 月 1 日,每家门店 5 分钟车程。Aspley 和 Sunnybank 的商圈分别只有 75.9% 和 72.6% 在该区域内:它们的数字只统计这一部分。
这份方案对布里斯班的网络说明了什么?
New Farm 是第一个关店候选:它有 99.4% 的居民,同时也在另一家店的 5 分钟范围内,主要是 Fortitude Valley,关掉它只会让 227 人失去覆盖。接下来是 Aspley,它处在 Chermside 的阴影之下。
Sunnybank 排在第四,尽管它与任何其他门店都没有共享的居民。原因是规模:它的 20,170 名居民全是它自己的,而关掉前面三家之后,留下的人更少。这两个结果都不是对门店的评判;它们只是告诉您先看哪里。
在两个计划地点中,Holland Park 增加的新居民最多,有 24,734 人,Kenmore 增加 14,123 人。但 Holland Park 离 Mount Gravatt 很近:模型把 Mount Gravatt 吸引的居民消费从每年 A$ 2,642万降到 A$ 1,824万,变化 −31%。
Kenmore 覆盖的人少,但几乎不影响网络:最近的门店 Indooroopilly 只变化 −1.6%。两个地点合计每年将吸引 A$ 3,884万的居民消费,其中 A$ 840万来自连锁自己的门店,A$ 3,044万来自市场的其他部分。
这家连锁及其门店是为本例虚构的,并已载入 K-Stra 示例账户;社区、人口和消费则是真实的。吸引的居民消费是只针对居民的消费模型,采用酒吧和咖啡馆(bars & cafés)的消费模型:上班族、通勤者和访客不在其中,所以靠近市中心的门店,例如 Fortitude Valley,读数偏低。
规划一个门店网络要花多少积分?
Coverage 按点收费,不论是您的还是竞争对手的,不论是现有的还是计划中的。关店方案、开店方案和吸引的居民消费包含在同一次运行里,不另外收费。
没有坐标的门店会进行地理编码,每 1,000 个地址 1.5 积分,在运行结束时收费;您中途停止的运行,只为已经处理的地址付费。
- Markets & Brands(市场与品牌),一个品牌每个品牌 5 积分 · 任意品牌,用来框定区域5 积分
- Coverage,10 家门店和 2 个计划地点每家门店或候选地点 5 积分60 积分
- 门店文件导入每 10,000 行 1 积分1 积分
- 地图、关店和开店方案、导出免费
- 这份网络方案= 66 积分
- 按 Single report 积分包每积分 A$1.53 计,约 A$101;更大的积分包和月度方案更便宜。
应用会先报价每一步,您确认之后才会运行;运行失败不收费。
关于门店网络规划,人们还会问什么?
门店网络规划和门店蚕食分析有什么区别?
蚕食分析衡量您的门店重叠了多少。网络规划则用这些重叠来做决定:哪家店关掉损失最小,哪个候选地点增加最多,以及按什么顺序来。
为什么要一家一家地给关店排序?
因为每一次关店都会改变其他门店。一家店关闭后,它共享的居民会转到邻近的门店,那家店独自拥有的居民就变多了。每一步之后重新测量,得到的顺序才站得住脚,而不是一个只对第一家店成立的排名。
关店方案会把竞争对手算进去吗?
不会。它统计的是在您的任何一家门店可达范围内都没有门店的居民。这些人是您有可能输给竞争对手的人,所以这个结果应当读作风险,而不是已经发生的损失。
签租约之前,可以先测试一个地点吗?
可以。在地图上放一个点,并标记为 “Planned”(计划中)。分析会显示它能增加的新居民、能吸引的居民消费,以及其中有多少是从您现有门店分走的。
“吸引的居民消费”衡量什么,又不包括什么?
它是某个地点能吸引的商圈居民的潜在消费:用来在同一行业、同一区域内比较地点,绝对数值只是数量级。上班族、通勤者、游客和过路客不在其中,所以市中心、旅游区和车站附近的地点读数偏低。